Los dos artículos anteriores, Arquitectura de agentes y Cómo moler el oro de tus chats, trataron dos piezas: un agente personal montado sobre Hermes y el corpus que lo alimenta, extraído del historial de chats. La tercera pieza es la interfaz con la que trabajo con ese agente a diario: Hermes WebUI.
Quiero tener control sobre mis chats y poder elegir con qué modelo trabajo según me convenga. Cambiar de LLM sin tener que mudar también mi historial, mi configuración y mi forma de organizar el trabajo. Esa libertad es la razón por la que monté Hermes WebUI.
La soberanía tiene aquí un alcance concreto: administro dónde se conserva mi historial y decido qué proveedor procesa el contexto de cada conversación. Cuando uso una API externa, ese contenido sale de mi servidor. El control consiste en poder elegir esa dependencia y cambiarla.
Qué necesita un chat para trabajar de verdad
Un cuadro de texto que habla con un modelo lo tiene cualquiera. Para trabajar a diario, yo necesitaba cinco cosas:
- Proyectos separados, en vez de una lista infinita de conversaciones.
- Historial persistente con búsqueda, para recuperar decisiones y correcciones anteriores.
- Adjuntar documentos, sin tener que copiar y pegar todo su contenido.
- Solicitudes de aprobación para los comandos que el agente identifica como peligrosos.
- Acceso desde varios dispositivos, incluido el móvil, con el modelo que elija.
Hermes WebUI reúne esas funciones. Con ellas, el agente que ya usaba desde la terminal se vuelve más cómodo para el trabajo cotidiano.
Una interfaz de la comunidad
Hermes WebUI es un proyecto comunitario de Nathan Esquenazi, distribuido con licencia MIT. Su planteamiento es sencillo: Python en el servidor y JavaScript sin framework en el navegador, sin paso de compilación.
En su configuración predeterminada, ejecuta el agente dentro del mismo proceso y lee la configuración, la memoria y las habilidades -o skills- de la instalación de Hermes. Esa integración permite llevar al navegador buena parte de la experiencia de la terminal.
También obliga a cuidar la compatibilidad entre ambos proyectos. Antes de actualizar uno, conviene revisar qué requiere del otro. La interfaz forma parte del entorno de trabajo del agente, y un cambio puede afectar a todo el conjunto.
Instalarlo sin sorpresas
Lo instalé directamente en el servidor, sin contenedores. El arranque y los reinicios los gestiona systemd mediante una unidad de usuario. Para que ese tipo de servicio pueda arrancar con el servidor y seguir activo sin una sesión abierta, hay que comprobar la configuración de persistencia del usuario, conocida como linger. Los permisos para habilitarla dependen del sistema.
Lo primero fue fijar la versión. Las etiquetas estables disponibles se habían quedado en agosto, antes de la versión de Hermes que estaba usando. Elegí una etiqueta experimental reciente y fijé su commit, en lugar de seguir una rama que podía cambiar. La fecha sirvió de orientación, pero por sí sola no garantiza compatibilidad, por lo que hay que revisar los cambios y probar la combinación.
Antes de arrancar, hice una comprobación básica: pedirle al intérprete de Python del propio Hermes que importara el agente. Superar esa prueba permite detectar algunos problemas de entorno; después queda comprobar que la interfaz funciona. En mi instalación no hizo falta añadir dependencias.
El servicio escucha solo en la dirección de loopback, accesible desde la propia máquina, y nunca en una interfaz pública. En mi caso, arrancó con un consumo de unos 130 MB de memoria. Es una medida de esa instalación al inicio, no una previsión de lo que consumirá mientras trabaja.
Acceder desde fuera con identidad verificada
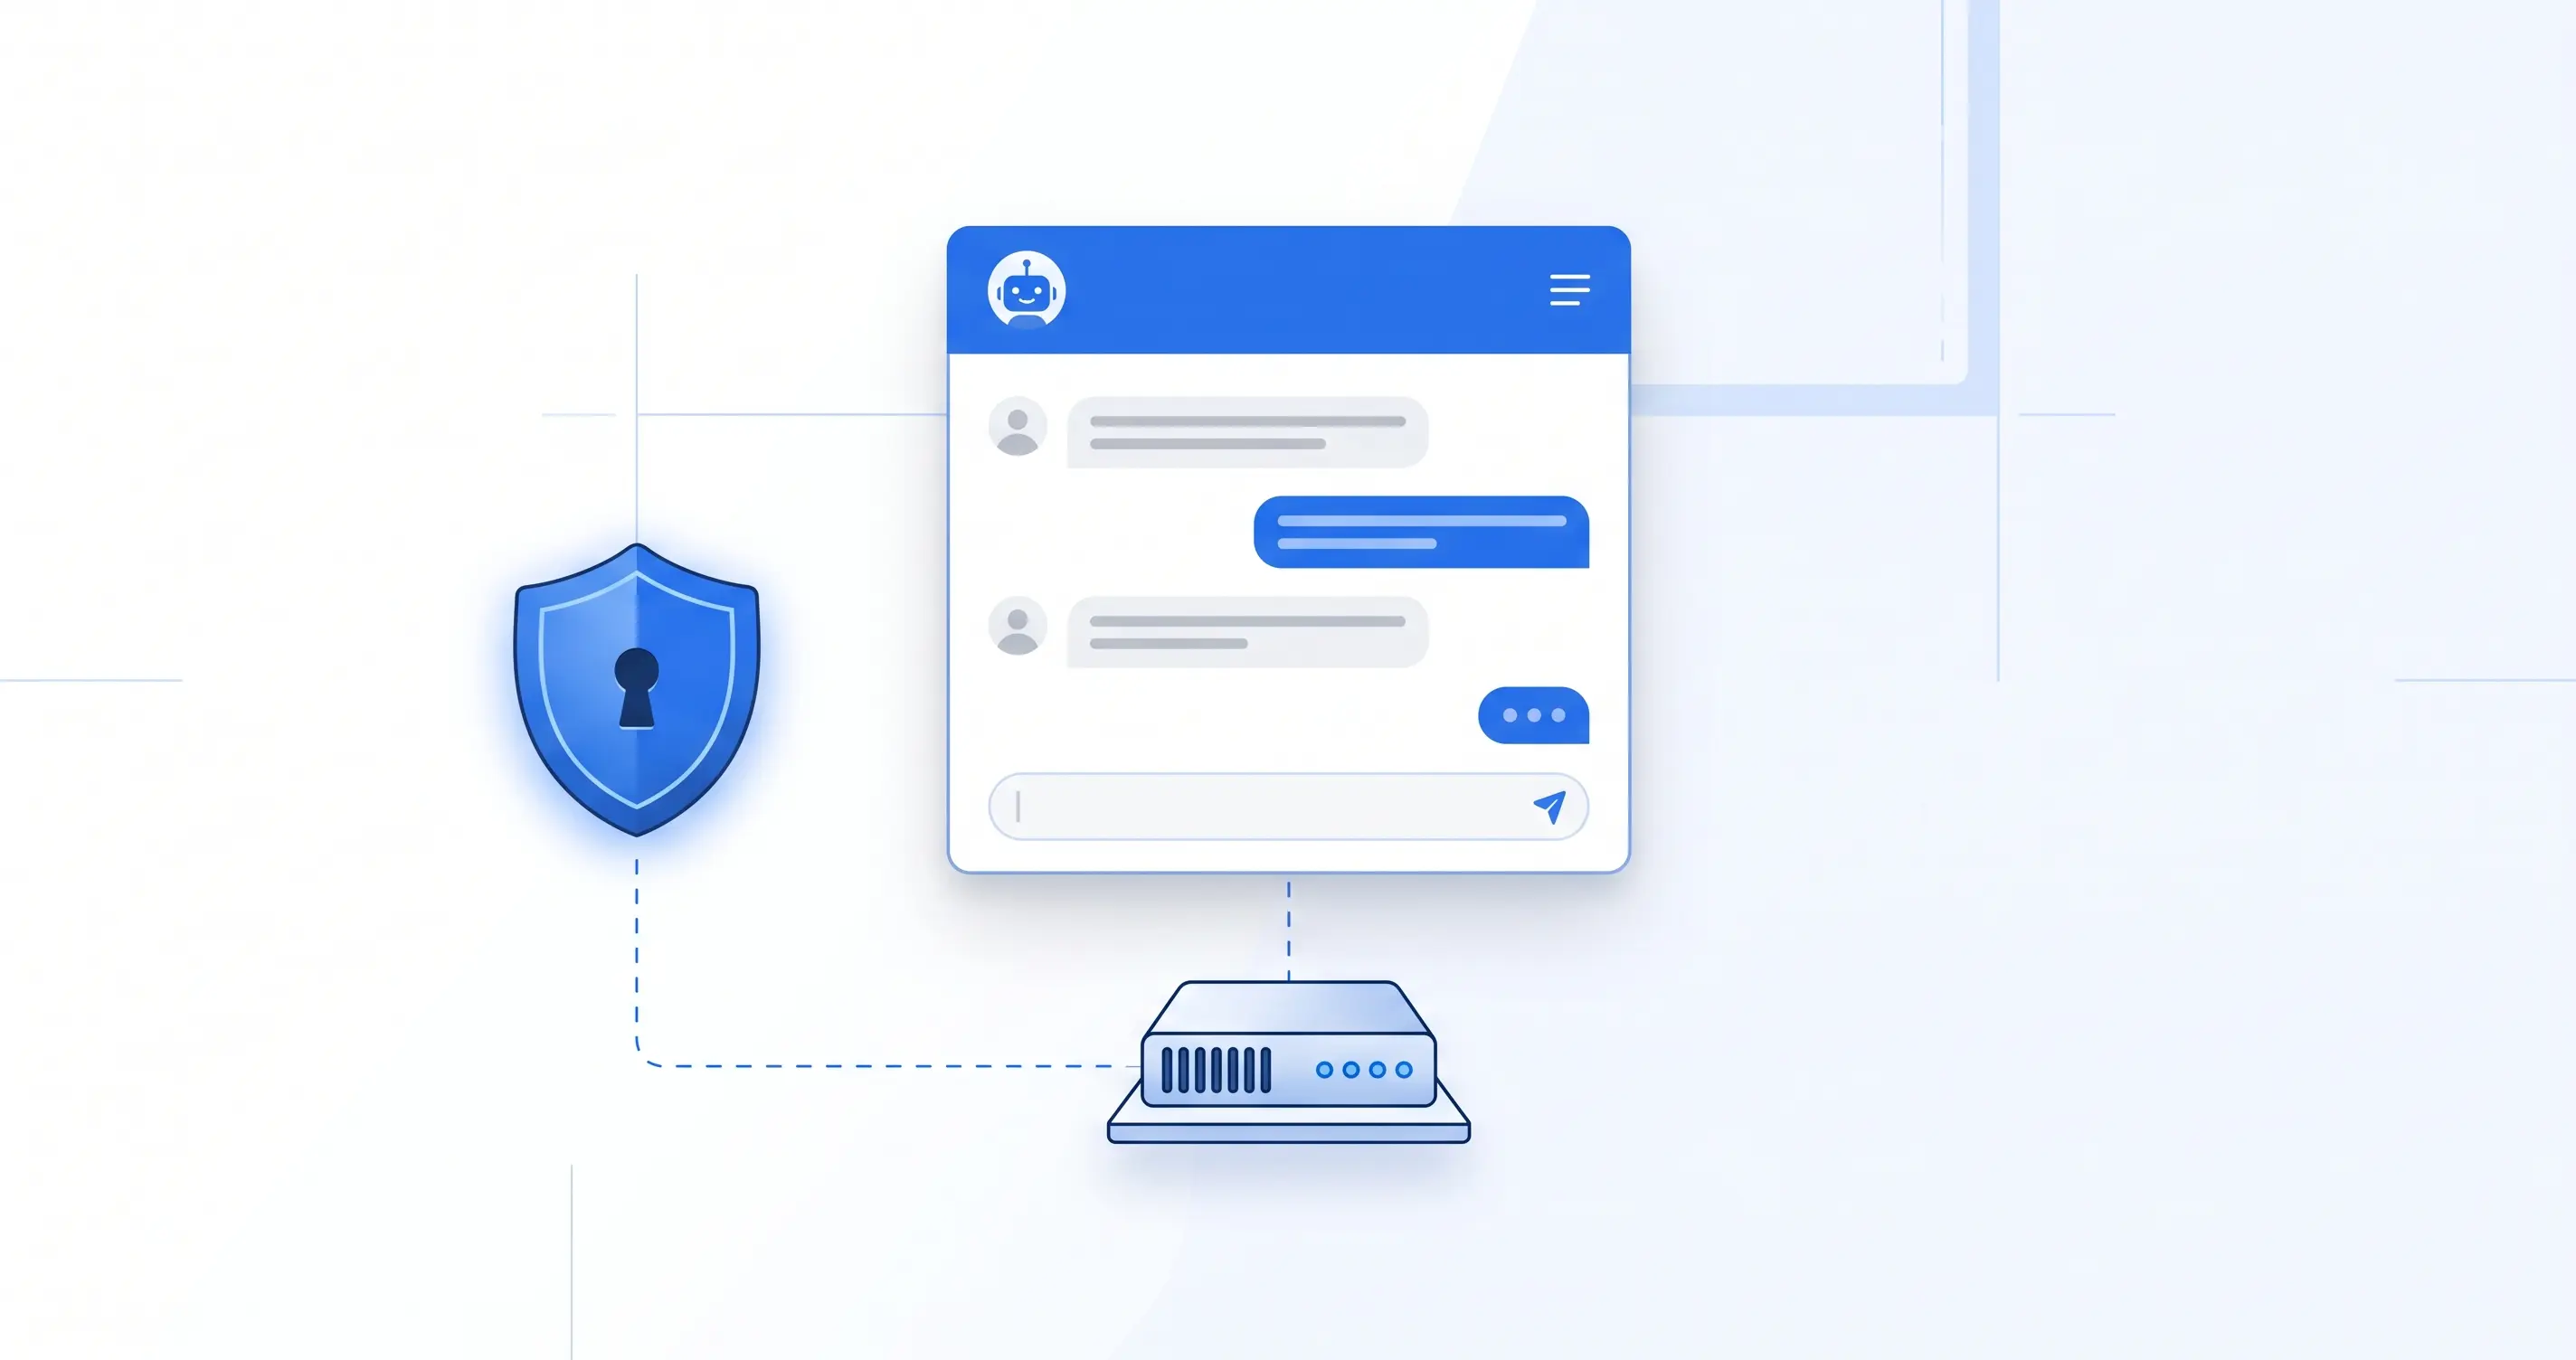
Para entrar desde internet utilicé Cloudflare. La arquitectura tiene dos piezas: Access controla quién puede entrar y Tunnel conecta el subdominio con el servicio que corre en el servidor.
Access queda delante de una dirección como chat.tudominio.com. El inicio de sesión con Google acredita la identidad; la política de Access debe permitir únicamente las cuentas autorizadas. Tener una cuenta de Google no basta para entrar. Esa distinción entre identificarse y tener permiso es esencial en la configuración de las políticas.
El túnel establece la conexión desde el servidor hacia Cloudflare y lleva las peticiones al servicio local. Así puedo acceder al chat sin abrir un puerto nuevo de entrada en el cortafuegos del servidor.
Dos detalles de configuración evitaron problemas. El primero: apuntar el túnel a 127.0.0.1, en lugar de localhost, si la interfaz escucha en IPv4. El nombre puede resolverse primero a IPv6 y dejar ambos extremos sin conexión. El segundo: en este montaje, el tramo entre el conector del túnel y la interfaz usa HTTP porque permanece dentro de la misma máquina. La conexión del navegador con Cloudflare usa HTTPS y el túnel hasta el servidor va cifrado.
Conservé la contraseña de la interfaz como vía de recuperación para un acceso directo mediante un túnel autenticado. Access y esa contraseña pueden aportar capas de protección distintas. Mantener el servicio en loopback reduce su exposición, pero no sustituye el control de las vías por las que se llega a él.
La subida de archivos que no funcionaba
El chat ya funcionaba, pero subir un archivo fallaba siempre. En lugar de completarse la carga, aparecía un desafío de Cloudflare.
El evento de seguridad apuntaba al conjunto de reglas de Cloudflare basado en OWASP. Las siglas corresponden a Open Worldwide Application Security Project, una fundación sin ánimo de lucro dedicada a mejorar la seguridad del software. Entre sus proyectos hay un conjunto de reglas para detectar peticiones potencialmente maliciosas, que Cloudflare adapta en su producto. OWASP es la organización; las reglas que se estaban activando eran la implementación de Cloudflare.
Ese conjunto suma una puntuación cuando encuentra patrones sospechosos en una petición. Al superar el umbral configurado, aplica la acción prevista. En mi caso, las subidas estaban provocando un desafío que impedía completarlas. Cloudflare advierte que estas reglas pueden producir falsos positivos: tratar como sospechosa una petición legítima.
Lo resolví con una excepción para el subdominio que omitía tanto el conjunto OWASP como el conjunto general de reglas gestionadas de Cloudflare. En el panel, estas excepciones se configuran desde Security rules -reglas de seguridad-. La excepción determina qué comprobaciones se omiten; los conjuntos gestionados contienen las reglas de detección. Cloudflare Access sigue encargándose de autorizar quién entra al chat.
Las cargas volvieron a funcionar, aunque la excepción fue amplia y esas comprobaciones dejaron de aplicarse a las peticiones del subdominio. La lección que saco es identificar la regla que provoca el bloqueo y, cuando sea posible, limitar la excepción a esa regla y a la ruta de subida. Cloudflare permite crear excepciones con ese alcance. Así se puede corregir el falso positivo conservando las demás comprobaciones.
También en el móvil
Desde el móvil, abro la dirección en el navegador y la añado a la pantalla de inicio. Queda como un icono que abre el chat a pantalla completa. En iOS puede ser necesario iniciar sesión de nuevo al abrirlo de esa manera.
Lo que cuesta usarlo
Hermes WebUI no añade una suscripción por usar la interfaz. Aun así, un chat propio tiene costos: servidor, dominio, copias de seguridad y consumo de las API que utilice. Si parte de esa infraestructura ya está pagada, el gasto adicional puede concentrarse en el modelo.
La API factura tokens de entrada y de salida. La entrada puede incluir instrucciones, mensajes anteriores, documentos y resultados de herramientas, además del mensaje que acabo de escribir. Por eso una pregunta corta dentro de una sesión larga puede costar más que una petición extensa en una conversación nueva.
Tampoco hay una equivalencia fija entre un mensaje y una llamada: el agente puede consultar al modelo varias veces mientras ejecuta herramientas. Y el historial guardado no tiene por qué coincidir con el contexto enviado en cada llamada, porque puede resumirse o compactarse.
Uso la API de Anthropic con Claude Sonnet 5. A 25 de septiembre de 2026, la tarifa publicada es de USD 2 por millón de tokens de entrada y USD 10 por millón de salida. Hay tarifas distintas para la escritura y la lectura de caché.
Un ejemplo permite situar esas cifras: una llamada con 20.000 tokens de entrada y 2.000 de salida cuesta USD 0,06 a las tarifas estándar, sin caché ni cargos adicionales. Si la entrada sube a 200.000 tokens y la salida se mantiene, cuesta USD 0,42. Son ejemplos de cálculo, no mediciones de mis conversaciones.
La caché de contexto puede reducir el costo de procesar contenido repetido cuando se configura y se cumplen sus condiciones. Por eso tampoco sería exacto decir que todo el historial se cobra siempre de nuevo al precio íntegro de entrada.
Los indicadores de contexto y costo de la interfaz ayudan a seguir el consumo; para conocer el gasto efectivo, la referencia es el registro del proveedor. Mi regla de trabajo es abrir una conversación por tema y dejar de arrastrar contexto cuando ya no aporta. Hasta dónde puede llegar una factura descuidada lo cuento en El día de los 83 dólares.
El pago por uso puede salir más barato que una suscripción, pero también más caro. El importe depende del modelo, del contexto y del número de llamadas que haga el agente. Tener el chat en casa no cambia esa cuenta.
Los límites y el mantenimiento
Los reportes del repositorio permiten hacerse una idea de los problemas que pueden aparecer. Hay un reporte de esperas de entre 4 y 7 segundos al sincronizar sesiones largas bajo carga, otro sobre sesiones bloqueadas y cambios de modelo sin aviso, y varios sobre desajustes entre perfiles (#5619 y #7259).
Son incidencias reportadas en determinadas condiciones y versiones. No demuestran que todos los usuarios vayan a encontrarlas, ni permiten atribuirlas sin más al carácter comunitario del proyecto. Sí sirven para saber qué revisar antes de instalar o actualizar.
La responsabilidad práctica es clara: leer los cambios, comprobar la compatibilidad, conservar copias del historial y la configuración, y poder volver a una versión que funcionaba si una actualización falla. También conviene verificar después que siguen funcionando las tareas básicas: conversar, adjuntar archivos y recuperar sesiones.
Ese mantenimiento forma parte del precio de tener infraestructura propia. La instalación termina; la responsabilidad continúa.
Un chat propio
La arquitectura mantiene la separación de los artículos anteriores: una capa de agente y un modelo de razonamiento que puedo cambiar. Mi historial, mi configuración y mi memoria de trabajo permanecen en el entorno que administro, aunque las capacidades y los costos varíen con el modelo elegido. Puedo elegir un LLM por su calidad, su precio o su conveniencia, y volver a cambiar cuando esas condiciones dejen de servirme.
Claude y ChatGPT seguirán teniendo sitio en mi trabajo. Con Hermes WebUI, la continuidad de mis chats queda bajo mi control y la elección del modelo sigue abierta. Esa es la utilidad que busco, gobernar mis datos y decidir con quién los proceso.
Montarlo puede llevar una tarde si el servidor y el agente ya están preparados. Mantenerlo exige atención recurrente. Ese mantenimiento es parte del costo de ejercer esta libertad: conservar mis conversaciones bajo mi control y elegir con qué modelo continúo trabajando.
Por: Cesar Rosa Polanco - Escrito a partir de una experiencia real, con asistencia de inteligencia artificial como herramienta de apoyo editorial.